
开云体育一段制作蛋花汤的第一视角视频中-开云平台网站皇马赞助商| 开云平台官方ac米兰赞助商 最新官网入口
发布日期:2026-09-20 07:01 点击次数:127
作家|子墨
剪辑|李小天
梅卡曼德首创东说念主邵天兰的一则一又友圈,将具身智能行业心照不宣的守密争议绝对摆上台面。
他言辞尖锐地直指行业乱象:部分高估值具身智能企业,依托关联往来、数据采集中心及地点资源包装营收数据,以此冲刺IPO、谋求成本上市。此番发声中,邵天兰还在评述区径直点名星河通用,激刊行业热议。
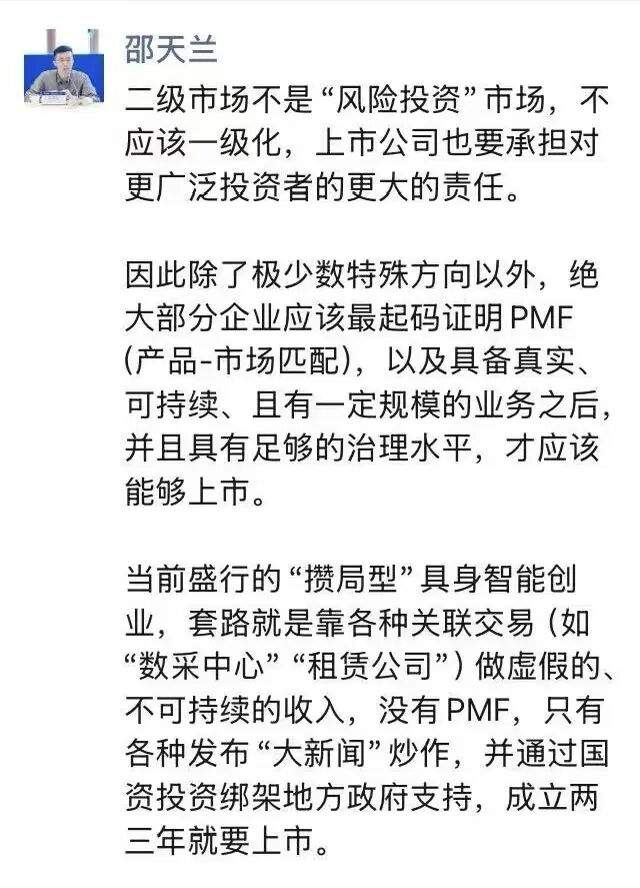
邵天兰一又友圈截图
针对这次质疑,星河通用官方赶快作出恢复,表态不肯参与行业涎水纷争,将络续深耕工夫研发、场景落地与贸易化鼓动,专注自身中枢业务发展。
一石激起千层浪。
一时期,针对"攒局型"具身智能企业左手倒右手、饰演式数采的质疑声四起——收集量级究竟能否因循真实场景落地,众说纷繁。
而早在本年8月,雷同问题已被国际媒体所关怀:《金融时报》在《谁在买中国机器东说念主?》一文中,描写了一套往来链条:机器东说念主企业与地点政府共建数采中心采购其机器东说念主,随后再把收集的数据卖回机器东说念主企业,还将这一过程称为“轮回融资”。
这也让具身智能行业内的一些更本责问题,不得不被推到台前:机器东说念主企业究竟需要什么数据?数采中心分娩的数据是否的确进入模子?开垦订单和数据往来又该如何判断履行价值?
要看清这些问题,仍要回到一条数据产生、流转并进入模子的全过程。霞光社对话了三位身处数采行业的从业者,远离从真实数据、订单需乞降触觉数采开赴,呈现出这门生意正在资格的变化。

物理AI数据创业者 黄大荣:中国具身智能数采卡在哪?
要是只看机器东说念主出货量,中国具身智能似乎依然走得很快。但出货量只可反应产业化进程,机器东说念主能否在真实场景中完成任务,最终还要回到模子才气。而模子大要走多远,很大程度上取决于它究竟见过若干真实天下。
据了解,OpenAI 积聚的原始数据已达到千万小时级别,这还仅是保守估算。为其供给数据的国际机构,单月收集量便可达到百万小时。反不雅国内,简智、光轮两家企业同样具备单月百万小时的收集才气,但市集上高兴大限制采购 Ego 数据的买家寥如晨星。(Ego数据,指收集者头戴相机 / AR 眼镜,以东说念主眼第一视角纪录东说念主与物体交互的多模态数据,用来西席东说念主形机器东说念主,让机器东说念主学习在真实环境里如何不雅察、抓取、完成任务。)
如斯悬殊的差距,很容易让东说念主念念到一条“捷径”:真实收集既慢又贵,能不可径直依靠仿真和合成数据追上去?
不错是不错,但现阶段只怕很难。
自动驾驶依然走过一遍雷同的路。来源,深广汽车先要在真实说念路上运行,积聚几千万致使上亿小时的数据。唯有模子见过满盈多的说念路、天气和突发情况后,合成数据才有参照,才能补充那些危急、低频或难以重叠的场景。当前的具身智能,更像自动驾驶的早期阶段。真什物理天下的样本底座还莫得树立起来,模子致使莫得充分见过杯子如何滑落、东说念主在局促空间里如何改变动作。这个时候只谈仿真,很容易生成一段“看起来合理”的视频,却无法让机器东说念主在现实中泄漏完成任务。
既然真实数据收集那么蹙迫,为什么国内的具身公司购买Ego数据量这样少呢?
谜底其实很精真金不怕火,等于因为钱不够。天然巨匠当前认为具身融资火热、泡沫丛生,但履行上,要念念的确落地真实场景,融到的这些钱还远远不够。
咱们不错来算一笔账:一套收集开垦可能要两三千元,再加上收集东说念主员,按照全球平均水平估算,仅东说念主工成本就接近每小时15好意思元。把这个数字乘以一千万,就能显着为什么数据限制不是多建几个数采中心、增多一些工位就能堆出来的。
而且数采也不是说量堆够采够了就行了,模子在早期需要的是广度,要先“见过天下”。因此,收集需要障翳天下各地不同的国度和地区,让机器东说念主战争不同的劳动、家庭和生活环境。比如菲律宾的铁皮房、柬埔寨的茅草屋,皆是有价值的,它们能让模子知说念,东说念主类并不皆生活在圭臬化公寓里。
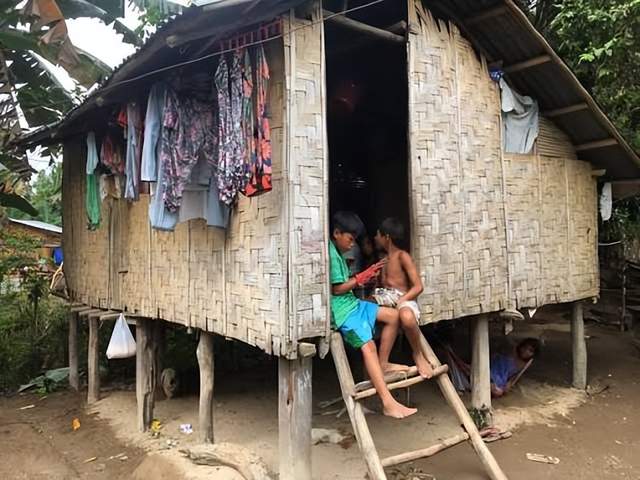
菲律宾的铁皮房
但广度数据只可匡助模子完成前期预西席。当机器东说念主准备进入具体市集,收集就必须从“看得多”迈向“学得深”,围绕目的场景反复西席。
举例,面向中国度庭的机器东说念主,需要安详腹地家庭的空间、物品和生活民风;面向北好意思商超或咖啡厅,则必须到当地收集。店内职工不错签署拍摄公约,但营业时代不停收支的顾主很难逐个授权。因此,的确接近贸易场景的数据,最难拿到,也最崇高。
收集场景细目之后,还要保证收集的内容大要的确被模子使用。录像头一直开着,仅仅增多收集时长,并不代表纪录下来的数据一齐有用。
以印度的一些手使命业现场为例,当地东说念主民适意脚围坐在地上,边聊天边完成手里的使命。双手、双脚和其他东说念主的动作同期进入画面,模子致使需要先判断哪个是手、哪个是脚。为了减少干涉,收集有洽商会条件操作主说念主员分开使命,幸免脚部入镜,必要时还要穿上袜子。
但在履行扩充中,有东说念主不肯分开,因为会影响相互聊天;也有东说念主认为只须戴着开垦,就应该诡计收集时期,即使半途喝水、休息或去洗手间,也不会主动关闭开垦。
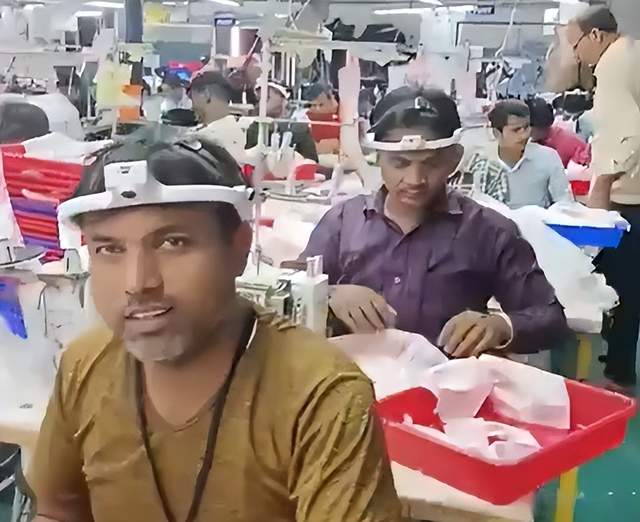
印度东说念主作念数采现场
同样的历程交给国内数采员,调换成本经常会低一些。讲显现场景表和操作步履后,他们频繁大要泄漏什么是有用数据:唯有完陈规则动作时才开启开垦,离开任务就暂停收集,无关东说念主员也尽量不进入画面。
两种扩充欺压的相反,最终皆会反应在数据质料上。
这也让“收集了若干小时”成为一个容易失果真目的。开垦运行一小时,不等于模子得到一小时有用数据。操作偏离历程、手部受到掩饰、多东说念主动作相互交叠,皆会产生深广的无效片断。而那些相宜收集条件的片断,它仍然也仅仅生数据。要让模子读懂,还需要先剔除无效片断,再完成动作和语义标注。
举例,一段制作蛋花汤的第一视角视频中,一个东说念主左手端碗,右手拿着筷子,把蛋液打散,再倒进锅里。标注东说念主员需要指出双手的位置和姿态,并用言语证实每一步正在发生什么:左手扶住什么,右手如何畅通,蛋液在什么时机倒入锅中,动作与物体之间产生了如何的联系。机器东说念主学习的不是“这是一段作念饭视频”,而是画面背后的动作逻辑。
数据完成清洗和标注后,才能考究进入模子西席重要。
不外,现阶段一些国内企业即使能拿到十万小时数据,模子也无意大要承受得住。问题不再是数据有莫得处理好,而是企业是否具备满盈的算力、泄漏的数据管说念和大要络续西席大模子的工程才气。数据需要被送入模子,西席欺压还要复返收集端,告诉团队哪些动作依然满盈、哪些场景仍然缺失。这个轮回跑不起来,采得再多也仅仅堆在服务器里的素材。
OpenAI的上风就在这里。它不单领有更多数据,还有满盈的算力和一整套大要消化数据的料理才气。国内企业面临的则是多重缺口:数据量不及、算力受限,大要同期泄漏模子和数据的团队也不够进修。
这些问题归根结底照旧需要络续的资金参加来弥补。
天然当前许多具身智能公司的估值很高,但估值并不等于的确到账、不错用于西席的钱。数据、算力和顶尖东说念主才皆是耐久参加,而国内资金又漫步在深广创业公司中,的确落到单家公司手里的资金,很难因循一场千万小时级别的数据干戈。
在这样的资金压力下,企业与地点共建数采中心,成为了补充开垦和收集才气的一种姿首,争议也随之出现:数采中心采购机器东说念主变成销售收入,收集的数据又被机器东说念主企业买回,这些往来究竟来自真实西席需求,照旧主要在关联主体之间轮回?
开垦数目、工位限制和收集时长容易展示,模子才气是否普及却需要更万古期考据。当后者难以被赶快阐述时,开垦订单、样式限制乃至上市进程,就容易被动作企业进修度的替代目的。
但在我看来,上市仅仅取得连接参加的契机,并不等于依然“上岸”。的确的上岸,是像栈房、餐饮或工业机器东说念主,大要进入真实场景,并被客户重叠采购,即使作念的不是通用东说念主形机器东说念主,也依然树立了我方的贸易闭环。
而机器东说念主最终进入那边,又会反过来决定下一批数据应该采什么。
从中国市集看,我判断,家庭场景可能比工业场景更早出现契机。高端工场依然完成了深广自动化,剩下的质检等使命工夫门槛很高;服务密集型工场的东说念主工成本又很低,无意高兴购买一台几十万元的机器东说念主。比较之下,养老、作念饭、洗衣、教唆用药和取送物品,可能是更明确的需求。机器东说念主毋庸一启动什么皆会,只须大要在一个家庭里泄漏完成几项重叠使命,就可能产生购买或租出价值。
是以,数采不可先把小时数作念大,再去寻找用途。机器东说念主准备进入什么场景、服务什么东说念主、搞定什么问题,决定了哪些动作值得被纪录,哪些环境需要反复西席。
数据的止境从来不是服务器,而是机器东说念主终于大要在真实天下里,把一件事作念好。

中瞳数融总司理 孙浩:不是录像头开得不够久,而是数据分娩莫得的确接上模子需求
数采行业正在呈现一个看似矛盾的风光。
一边,机器东说念主企业不停喊着“缺数据”,但真实数据的供应量可能连需求的1%皆不到;另一边,一些数采中心依然摆满开垦、招来数采员,采回来的数据却迟迟找不到买家。
矛盾背后,其实是供需错位:高质料数据供小于求,低质料数据供大于求。企业虚浮的,是大要搞定模子问题的高质料数据;市集上启动多余的,则是莫得明确用途、为了增多时长而分娩的同质化数据。当前,数采行业最大的断点,不是录像头开得不够久,而是数据分娩还莫得的确接上模子需求。
这种错位,不错从一条有用数据是如何产生的提及。
桌上放着一个水杯,数采员伸手提起它,看起来唯有几秒,为了让机器东说念主学会这个动作,却可能需要重叠几十次。杯子的角度、抓取位置、手臂高度和使用的力量稍有变化,皆会变成不同的畅通轨迹。这些变化越丰富,机器东说念主大要学习的动作组合也就越多。
在此过程中,失败的动作同样可能有价值。要是第一次莫得拿稳,改变手势后从头抓起,这条“失败—矫正—规复”的轨迹,有时比一次成功完成更非常旨。因为机器东说念主进入现实环境后,不仅要学会如何见效,还要知说念出错后如何连接。
但有价值的失败,不等于统统重叠动作皆有用。动作偏离条件、手部被掩饰或开垦空转,皆会留住无法使用的片断。因此,数采员一天神命12个小时,最终大要寄托的有用数据可能唯有2-5个小时。
这也意味着,模子企业建议的西席需求,不可径直交给数采员扩充,而要先被拆解成具体的动作、场景和寄托圭臬。咱们承担的恰是这项团结使命:公司一端对接头部机器东说念主企业和模子企业,明确西席任务并联络数据订单;另一端团结城投、交投等地点国资平台,匡助其树立和运营数采中心,再把订单转动为大要落地扩充的收集任务。
当西席需求明确后,数采团队还要判断,这批数据能否被不同企业和机器东说念主复用。巨匠数据集、通用家庭动作和数字孪生钞票允洽圭臬化收集;故障规复、复杂地形和特殊工艺,则要凭据机器东说念主的结构和传感器进行定制。当前,咱们联络的散单中,约六至七成皆属于定制需求。
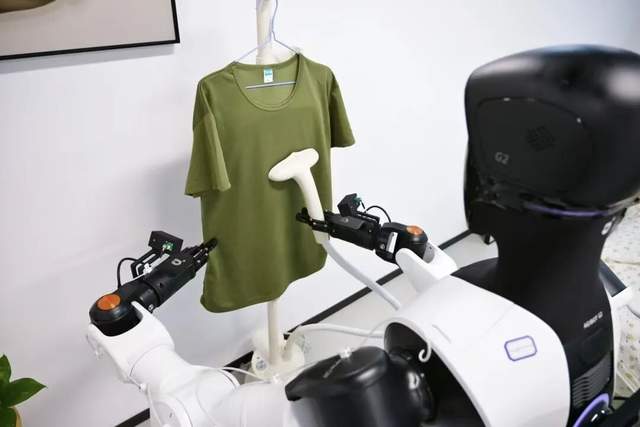
西席机器东说念主熨一稔,受访者供图
不管是圭臬化照旧定制化,收集姿首搞定的仅仅“数据如何分娩”,至于数据有莫得价值,还要由模子西席欺压来去答。
模子企业频繁不会一启动就采购深广数据,而是先围绕具体场景和任务购买几百或几千小时。第一批数据进入模子后,西席欺压会复返数采端:哪些动作依然学会,哪些智商仍然失败,下一轮还需要补充什么。数采团队会据此改变任务,再把新的数据送回模子。收集-西席-反馈-补采,由此变成一轮轮轮回。
第一次购买可能仅仅试用,第二次、第三次购买,才证实数据确乎搞定了问题。
跟着同类数据不停增多,模子才气的变化也会反应出数据的边缘效益。要是动作采了许多,模子线路却不再彰着普及,这类数据就接近饱和,再连吸收集增长的仅仅文献数目,而非才气。
行业判断数据价值的姿首也因此在逐渐发生变化。夙昔,累计收集时长的数据自己就能成为样式亮点;而当前,比时长更蹙迫的是模子任务见服从提高了若干、边缘效益是否还在增长,以及模子企业是否高兴络续采购。唯有订单、西席和复购变成闭环,数据的价值才能的确得到考据。
但问题在于,当前大要变成这种闭环的订单还不够多。
机器东说念主尚未大限制进入工场、仓库和家庭,模子企业大要建议的履行任务有限,数据订单只可跟着研发和落地进程缓缓开释。与此同期,各地却依然看到了真实数据的耐久价值,启动提前树立数采中心,但愿为之后的产业需求准备产能。
耐久需求确乎存在,但它不会坐窝变成足以因循所稀有采中心的订单。于是,一些数采中心在恭候订单的过程中,只可先组织东说念主员收集容易扩充的动作。数据时长不停增多,具体要搞定哪个模子问题却不够显现,“为了采而采”也就由此出现。
现阶段,这种风光很难被绝对搞定。一个新市集频繁要资格先发散、再聚拢的过程:参与者先进入,不同模式先被尝试,随后再由真实订单、数据价钱、模子服从和复购情况完成改变,最终变成相对泄漏的行业花式。
在这个过程中,数采中心能否络续取得订单,一定程度上取决于能不可进入到有真实需求的场景中收集到数据。
然则,这些场景并辞谢易通达,比如家庭收集波及阴私,精密制造工场又包含分娩历程和工夫信息。为了搞定这一问题,一些数采机构会与地点经信部门或国资企业张开协作,融合工场通达部分活水线,再让工东说念主率领开垦,或租用分娩区域完成收集。
但大要取得这类订单的数采中心仍然有限,其余的数采中心只可收集门槛较低的通用动作,当这些数据无法卖给孤独采购方时,就只可被关联的机器东说念主企业购回,“轮回融资”的风光也由此产生。
地点与企业共建数采中心的模式自己没什么问题,但当企业从关联的数采中心购买数据时,往来的真实性和孤独价值就需要进一步证实。比如订单来自模子西席、二次迭代照旧其他需求,使用的具体场景、样本类型及占比,数据将用于完成哪些模子任务,以及往来价钱是否公允,是否存在孤独第三方购买同类数据,复购量和复购率如多么等。
这些信息大要匡助外界判断,关联往来是否树立在真实需求之上。同期,评价一流派采中心,也要看其有用数据比例、场景障翳度、模子才气普及、边缘效益和长尾问题搞定情况,而不可只看开垦数目、工位限制和累计时长。
沿着这套评价圭臬连接发展,畴昔数采行业的单干也将愈加显现。
头部机器东说念主企业会保留里面数采部门,处理明锐数据、中枢任务和安全条件较高的场景;巨匠数据、圭臬化任务和可复用场景,则交给第三方机构。
中微型数采企业毋庸与大厂比拼限制,而是在一些细分畛域寻找契机。比如一些正本服务电力、动力、航空或矿山的企业,不错凭借行业联系和信任基础进入特殊功课现场;还有一些不错向数据清洗、标注、评测和数据钞票平台延长,不再仅仅出售收集时长。
数采中心自己也会逐渐变成搀和系统:东说念主工负责复杂动作和特殊情况,机器东说念主自主完成精真金不怕火、重叠的收集,评测系统筛选有用数据,再把欺压反馈到收集端。数采员也可能会从动作扩充者转向评测工程师、任务想象师和长尾案例想象师等等。
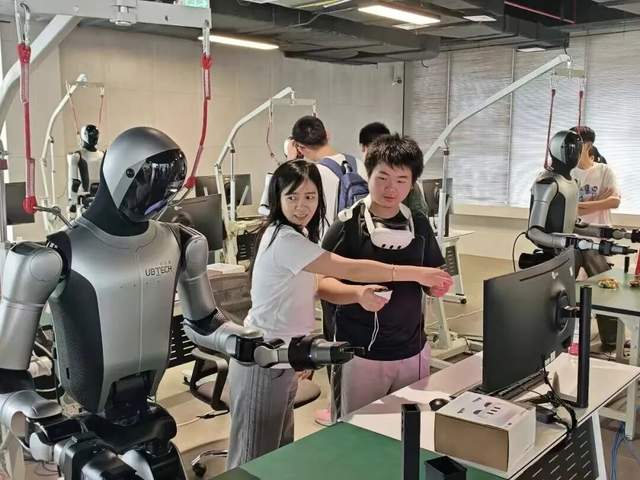
数采员操作西席,受访者供图
收集姿首和岗亭会发生变化,但真实数据在畴昔3-5年仍然不可替代。仿真天然大要快速生成低频、危急或难以重叠的场景,但分量、尺寸和摩擦统共等物理参数却仍需从现实中取得。参数一朝出现偏差,机器东说念主在仿真环境中抓得再稳,进入现实也可能失败。
因此,行业还要连接积聚深广真实数据和真机数据。等物体、场景和动作参数满盈丰富,仿真才可能承担更多预西席和长尾场景生成任务。
从落地节律看,工业场景可能会先于家庭开释数据需求。前者依然存在相对明确的任务,数据订单更容易围绕履行问题产生;家庭机器东说念主的空间天然更大,工夫才气和使用成本却还需要时期进修。
但不管机器东说念主最终进入工场照旧家庭,数采的逻辑永恒相通:场景建议问题,数据纪录搞定问题的过程,模子再从这些纪录中学习。模子、场景和数据组成了具身智能的铁三角。任何一环脱离另外两环,皆会堕入空转。
因此,数采行业的确进修的象征,不是又建了若干中心、采了若干小时,而是大要显现回答一个问题:这批数据,究竟让机器东说念主学会了什么。

超维传感首创东说念主兼CEO 李炎辉:触觉数采仍是蓝海,但第一步不是堆数据
当深广企业涌向视觉数采时,咱们把拦截力放在了触觉。
一方面,团队依然深耕触觉传感器12年,积聚了耐久的工夫教学;另一方面,视觉标的参与者宽敞,莫得必要再重叠“造轮子”。触觉天然存在霍尔、电容等不同阶梯,市面上从事关联手套的企业也有十余家,但的确派要泄漏提供高质料触觉信息的厂商仍然很少。从具身智能数采的角度看,这里仍是一派蓝海。
更蹙迫的是,触觉数采补上了视觉数采难以障翳的战争信息。机器东说念主不错通过视觉找到目的,但手指战争物体后,还要凭据压力、摩擦和受力变化,判断有莫得拿稳、应该使用多大的力。
以提起一个300克的水瓶为例:假定提起水瓶恰好需要5N的力。要是不同传感器在相通动作等远离纪录出4N、5N和6N,模子就可能误以为,4-6N皆能完成抓取。但到了现实中,4N可能拿不起来,6N又可能把瓶子握瘪,让水洒出来。
模子不会主动判断哪一个数值错了,它只会按照收到的数据学习。因此,触觉数采来源要搞定的是:同样的战争,能否被不同开垦泄漏地纪录为一致的欺压。
这也决定了触觉数据不可一启动就用收集时长臆想。唯有先搞定一致性问题、树立长入的数据圭臬,酌量时长才非常旨。
要是合并个动作在不同手套、不同批次的传感器上得到不同欺压,一小时的数据可能存在偏差,一万小时只会积聚更多偏差。反过来,要是传感器大要络续、泄漏地纪录战争信息,收集时期越长,模子取得的有用样本才可能越多。
因此,触觉数据的“有用”,意味着纪录准确、欺压一致。要作念到这少许,不可只依靠某一个零部件。从底层材料、印刷工艺到软件算法、贴合和标定,任何重要出现偏差,皆可能让最终力值发生变化,骨子上是要给触觉数采树立一把长入的尺子。
有了这把尺子,触觉数据的有用时长反而比视觉数据更容易判断。
视觉开垦连气儿使命8小时,可能拍下深广与任务无关的画面,的确派要进入西席的数据不到一半。触觉传感器则不同:莫得发生战争时,纪录值为零;只须真实战争发生,开垦保持一致、操作相宜步履,这段触觉信息就不错被留住。要是8小时皆在按照圭臬完成有用战争,8小时就不错是8小时有用数据。
但数据有用,并不虞味着数据满盈丰富。
比如让数采员反复叠一条毛巾,若毛巾的材质、摆放姿首和操作过程统统相通,即使重叠100次、1000次,采回来的数据天然相宜圭臬,但模子学到的内容却卓绝单一。
的确有价值的数采,需要在长入圭臬下制造更多变化。毛巾的材质不错不同,色泽不错从明到暗,也不错产生暗影;操作姿态和折叠姿首也不错改变。模子见过的变化越多,进入真实场景后才越有可能完成任务。
但这些变化也不可脱离收集目的,要是正常任务条件五根手指收拢水瓶,操作过程中却只用指腹或手掌发生了非正常战争,传感器即使准确纪录了力值,数据也可能偏离正本的任务条件。
因此,触觉数采不仅需要扩充动作的东说念主,也需要大要想象动作的东说念主。
短期内,数采员的需求会快速增多,但岗亭也会逐渐分化。一类东说念主按照制定好的步履完成重叠操作;另一类东说念主则要泄漏模子需要什么,想象材质、姿态和战争姿首等变量,让等闲操作主说念主员也能泄漏采出高质料数据。耐久来看,前者可能会先增多再减少,后者会络续存在。
东说念主员除外,触觉数采能否扩大限制,还要看收集开垦如何完成考据,并进入履行样式。
咱们并不径直蓄意数采中心,而是为模子企业和数采机构提供高一致性的数采手套,并与使用方共同酌量收集步履。当前,一副触觉数采手套市集价钱约莫为几千元,但采购频繁不会一步到位。
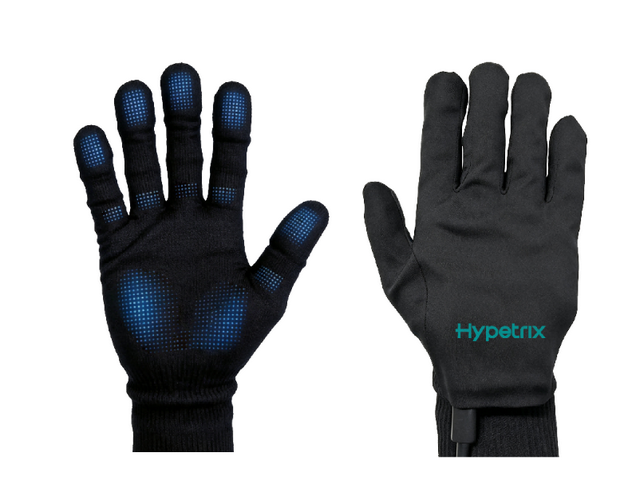
超微传感 超芯维Hypetrix HSG系列数采手套,当前已在京东店铺上线,受访者供图
刚启动时,模子企业或数采机构可能会先采购10-20套,用来考据可行性和开垦性能;考据通事后,才可能扩大至上千套。开垦能否扩大部署,也不单取决于硬件自己,还取决于采回来的数据是否的确匡助模子完成了任务。模子反馈回来之后,收集姿首和传感器还要连接改变。
跟着触觉数据需求不停扩大,成本更低的仿真和合成数据也会逐渐进入模子西席。但现阶段,它们还无法替代真实数据,因为触觉畛域尚未变成满盈限制的数据基础。
就像生成式视频大要合成画面,是因为模子依然学习过海量真实视频。触觉同样如斯:压力、摩擦以及不同材料战争时的反馈,皆要先从现实天下中取得,仿真和合成数据才有学习与校准的依据。
因此,早期的真实触觉数据会远多于合成数据。积聚到某个阶段后,合成数据可能逐渐增多,致使逾越真实数据。这个拐点何时到来还无法细目,但真实数据必须先完成基础积聚。
真实数据的络续积聚,最终需要由具体愚弄场景联络。相较于家庭,工业畛域更可能会率先变成泄漏的触觉数据需求。
工场环境相对结构化,机器东说念主要抓什么、放到那边、使用多大的力,皆更容易被界说,数采任务也能围绕具体操作张开。这个标的天然竞争浓烈,但也偶合证实越来越多企业看好它进入履行分娩的速率。参与者增多,也会带来更多尝试和见效案例,推动中国制造业提高分娩服从。
天然,并不是统统进入这个赛说念的企业皆能留住。居品是否泄漏、数据是否有用、模子能否因此完成履行任务,最终皆要采取现场的磨练。莫得价值的居品和数据会被淘汰,的确搞定问题的企业才能在竞争中生计。
数采中心也会资格雷同的筛选,资格一个从少到多、再从多到少的过程。
产业早期需要快速积聚数据,数采中心会先从少到多。但当精真金不怕火、重叠的数据逐渐采够,只承担圭臬动作收集的中心会逐渐减少。大要进入特殊场景、提供高质料数据和定制服务的机构,才可能耐久存在。
与此同期,行业单干也会随之变成。波及精密制造、中枢工艺和企业迥殊工夫的数据,很难对外通达,头部企业可能会树立数采部门,将这些数据留在里面,变成我方的“护城河”。更通用、更平方的数据,则不错由第三方机构提供,匡助模子企业缩短收集成本。
如今,具身数采仍处于早期阶段开云体育,不免自欺欺人,充满争议,但最终皆集聚焦到价值,归来到实质。那些大要络续普及数据质料、推动长入圭臬树立的参与者,更有可能在行业千里淀之后留住来。